Porady o tym, jak zostać cytowanym w ChatGPT, zwykle biorą się z czytania jego odpowiedzi i domyślania się, co dzieje się pod maską: pisz wartościowe treści, publikuj listy, bądź aktywny na Reddit. Suganthan Mohanadasan poszedł inną drogą. Otworzył panel sieciowy przeglądarki i przeczytał ruch, który ChatGPT wysyła sam do siebie. Wyłania się z tego bardziej mechaniczny obraz tego, jak model wybiera, które strony pobrać, które zacytować, a które pominąć. Ten artykuł opowiada jego przechwyt, dodaje jedyne zewnętrzne dane, które go potwierdzają, i mówi, co z tego wynika, a co nie.
Aktualizacja, lipiec 2026: pole z pipeline’ami opisane niżej pokazało później piątą wartość, bing, na części kont. Ten dalszy ciąg omawiamy osobno w tekście ChatGPT i źródło wyników Bing.
Najpierw słowo o metodzie i jej ograniczeniach
To odczyt jednej osoby, oparty na mniej więcej 1240 rekordach źródłowych zebranych przez kilka dni na jednym koncie Pro, z zapytaniami przechylonymi w stronę SaaS i tematyki technologicznej. Suganthan dzieli swoje ustalenia na dwa poziomy pewności i my ten podział zachowujemy.
Fakty strukturalne mają wysoką pewność: pochodzą wprost z przewodu, tak samo za każdym razem. Wewnętrzne nazwy pól, etykiety pipeline’ów, fakt, że część pytań w ogóle nie uruchamia wyszukiwania w sieci. Częstotliwości mają charakter jedynie kierunkowy: procenty i rankingi pochodzą z małej, mocno technologicznej próbki, a zapytania o zdrowie czy modę wyglądałyby inaczej. Mechanizmy są właściwym wnioskiem, a dokładne liczby to tylko migawka.
Nie każde pytanie w ogóle dotyka sieci
Zanim ChatGPT cokolwiek wyszuka, przypisuje twoje pytanie do kubełka. Suganthan zaobserwował sześć takich etykiet intencji, w tym jedną, która rozstrzyga sporo sporów o widoczność w AI: kubełek „text” odpowiada z pamięci treningowej modelu i w ogóle nie przeszukuje sieci.
Ma to jedną brutalną konsekwencję. Niektórych pytań po prostu nie da się wygrać treścią, bo żadna strona nigdy nie zostaje pobrana, żeby na nie odpowiedzieć. W jego teście na trzy z dziesięciu celowo aktualnych, ważkich pytań odpowiedziano bez żadnego wyszukiwania w sieci. A o kubełku decyduje sposób sformułowania pytania, a nie temat. „Najlepsza kawa w pobliżu” uruchamia pipeline lokalny. „Najlepsze telewizory 4K do kupienia” wyzwala zakupy. „Najlepsze telewizory 4K z recenzjami” zostaje w normalnym wyszukiwaniu. Ten sam przedmiot, trzy różne maszyny, trzy różne zestawy zwycięzców.
Zanim więc zaczniesz martwić się o pozycję w odpowiedzi AI, ustal, czy pytania, na których ci zależy, w ogóle docierają do sieci. Niektóre nigdy nie dotrą.
O tym, kto zostaje pobrany, decydują cztery pipeline’y
Dla pytań, które faktycznie uruchamiają wyszukiwanie, każdy wynik z sieci niesie wewnętrzną etykietę mówiącą, który pipeline go pobrał. Suganthan znalazł cztery wartości, a inni w branży niezależnie natrafili na to samo pole. Mówiąc wprost:
- serp to bazowa warstwa otwartej sieci, głównie wiadomości.
- labrador wygląda na warstwę licencjonowaną dla uznanych wydawców (pomyśl o Reuters, Guardian, WSJ, Wikipedia, arXiv), zaciąganą jako niemal kompletne fragmenty artykułów, a nie krótkie urywki.
- bright i oxylabs to nazwy komercyjnych firm scrapujących, Bright Data i Oxylabs, i to one wykonują całą ciężką robotę w otwartej sieci. W jego próbce Bright Data dominowała w zakupach, finansach i pogodzie, a Oxylabs skłaniała się ku prasie regionalnej i lokalnej.
Pojedyncze zapytanie o pogodę na przykład rozłożyło swoje źródła między pipeline’y: krajowe serwisy prognoz przyszły przez jeden scraper, gazety regionalne przez drugi. Nie masz kontroli nad tym, który pipeline cię podchwyci, ale ten wzorzec przypomina, że ChatGPT składa odpowiedź z kilku systemów pobierania naraz, a nie przeszukuje jednego indeksu jak Google.
Pobrany, cytowany i wspomniany to trzy różne rzeczy
Większość porad o widoczności zaciera to rozróżnienie. To, że model przeczytał twoją stronę, to, że powołał się na nią pod konkretnym zdaniem, i to, że nazwa twojej marki po prostu wypłynęła w odpowiedzi, to trzy odrębne wyniki, a tylko jeden z nich daje klikalny przypis. Każdy ma własny warunek zwycięstwa:
- Pobrany oznacza, że model wciągnął twoją stronę do swojego roboczego kontekstu. Nigdy tego nie widzisz i samo w sobie nic ci to nie daje.
- Cytowany oznacza, że twoja strona jest wskazana jako źródło konkretnego zdania, ten klikalny przypis.
- Wspomniany oznacza, że nazwa twojej marki pojawia się w odpowiedzi, często jako chip, bez bycia źródłem jakiegokolwiek twierdzenia.
Przepaść między pobranym a cytowanym to miejsce, gdzie ginie masa wysiłku. W próbce Suganthana Reddit został pobrany 278 razy, a cytowany 11 razy. YouTube pobrano 201 razy, a cytowano zero. Powód mechaniczny jest prosty: cytowania wiążą się z tekstem, który model faktycznie przeczytał, a strona YouTube zwraca metadane, nie transkrypcję, podczas gdy wątek na Reddit to sam czytelny tekst. To nie kaprys małej próbki. Ahrefs, badając 1,4 miliona zapytań, ustaliło, że Reddit był cytowany zaledwie w około 1,93% przypadków, w których się pojawiał, i że mniej więcej dwie trzecie wszystkich pobranych, lecz niecytowanych URL-i to był Reddit. Platforma jest bez przerwy używana do zrozumienia tematu i prawie nigdy za to nieuznawana.
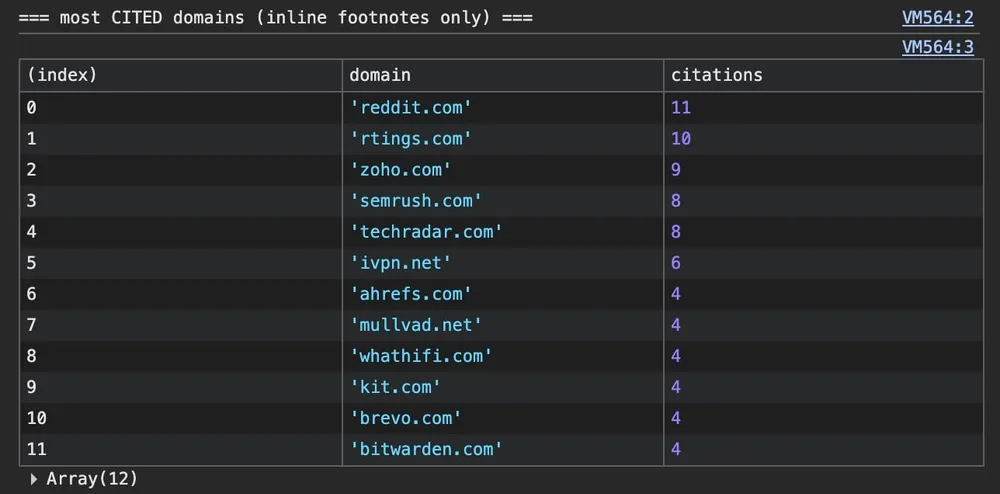
W tej liście kryje się jeszcze jeden mechanizm: wyniki deduplikują się po domenie. Dwadzieścia cienkich stron z jednego serwisu zapada się do jednego slotu cytowania. Publikowanie kolejnych wariantów tej samej strony nie kupuje ci większej obecności.
Taki sam rozdźwięk między „cytowany” a „polecany” widać w AI Overviews od Google. Ten pomiar omawiamy w tekście Dlaczego „jesteśmy najlepsi” szkodzi w AI.
Jedno pytanie staje się dziesiątkami wyszukiwań
Gdy ChatGPT używa trybu „myślenia” przy pytaniu porównawczym, nie uruchamia twojego zapytania. Uruchamia wiele. Suganthan obserwował, jak pojedyncze zadania porównawcze rozwijały się w piętnaście do czterdziestu podzapytań, a ponieważ te podzapytania są rejestrowane, można dokładnie odczytać, o co model pytał.
Zachowanie jest uderzająco dosłowne. Odpala sondy site: prosto w strony cenników producentów. Zgaduje cenę, a potem szuka, żeby ten domysł potwierdzić. Schodzi ze scenariusza i zaciąga konkurentów, których nigdy nie wymieniłeś, po czym poluje również na ich ceny. Gdy czyta stronę, przeszukuje ją pod kątem znaków dolara i konkretnych słów, jak „Agency” czy nazwa planu.
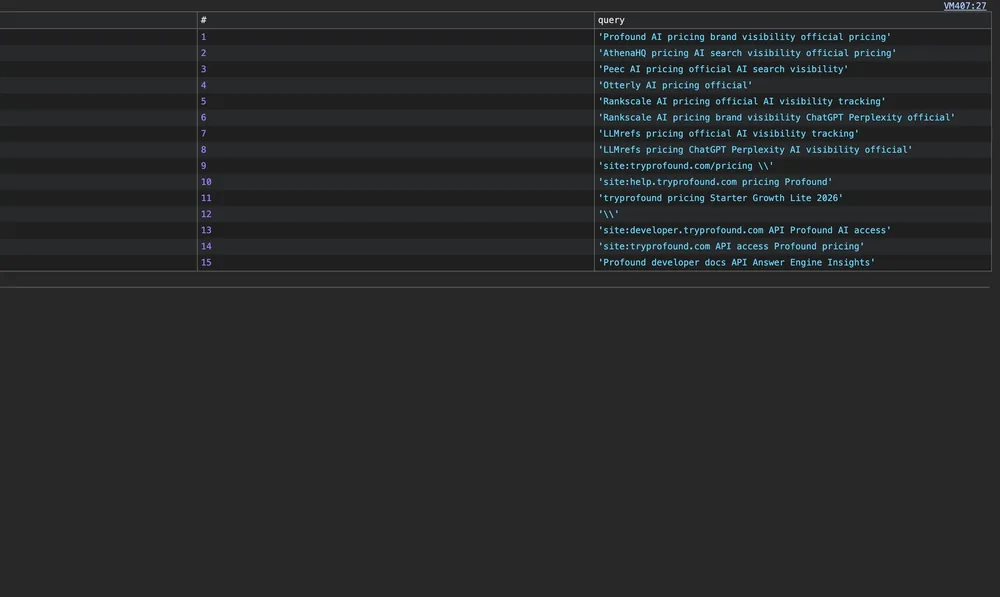
Lekcja dla widoczności jest niewygodna: nie konkurujesz o pytanie, które wpisał użytkownik. Konkurujesz o rój przepisanych podzapytań, których nigdy nie widzisz, a wiele z nich celuje w strony, których być może nie zoptymalizowałeś, jak twój własny cennik.
Twoją stronę czyta w poszukiwaniu faktów, cudze w poszukiwaniu opinii
Gdy Suganthan zajrzał do zapisanego rozumowania samego modelu myślącego, strategia była wyłożona zwykłym językiem. Przy twardych faktach, jak cennik i specyfikacje, model woli źródło oficjalne i mówi to wprost, wybierając aktualną stronę cennika ponad starszą wzmiankę u osoby trzeciej. Przy ocenach typu „które narzędzie jest najlepsze” werdykt czerpie od stron trzecich: hubów recenzji, serwisów porównawczych, społeczności.
Jedno zdanie warto zabrać z całego przechwytu i należy ono do niego: ChatGPT „czyta twoją własną stronę w poszukiwaniu faktów, o ile potrafi je sparsować, a cudze strony w poszukiwaniu opinii”. Dwa różne zadania, dwa różne źródła. Do ciebie należą fakty o tobie samym. Werdykt do ciebie nie należy i zdobywa się go gdzie indziej. Pozostałe teksty tej serii o wyszukiwaniu z AI opierają się na tym podziale i odsyłają tutaj, zamiast go powtarzać.
Ściana JavaScriptu
To ustalenie najbardziej dotyczy sposobu budowania stron. Gdy model poszedł ściągnąć cennik z narzędzi takich jak Profound i Peec, nie zdołał. Odnotował, we własnym rozumowaniu, że cen nie było w wyniku, bo strona ładowała je za pomocą JavaScriptu. Nie mogąc sparsować oficjalnej liczby, sięgnął zamiast tego po cytat od osoby trzeciej, decydując się użyć danych z serwisu recenzenckiego, bo oficjalna strona okazała się zbyt trudna do odczytania.
Dla faktów to cała gra. Jeśli twoje kluczowe liczby, twoje ceny, twoje specyfikacje, twoja dostępność, są renderowane przez JavaScript po załadowaniu strony, model może pobrać twoją stronę, nie odczytać faktu i oddać cytowanie temu, kto napisał o tobie zwykłym tekstem. Możesz być definitywnym źródłem faktu o własnym biznesie i wciąż przegrać cytowanie z serwisem porównawczym, wyłącznie z powodu tego, jak zbudowana jest twoja strona.
Co zmienić na własnej stronie
Z przechwytu wynikają dwa działania: uczynić fakty czytelnymi i nie liczyć na korzyść z ilości.
- Umieść swoje fakty w zwykłym, renderowanym po stronie serwera HTML. Ceny, specyfikacje, lokalizacje, godziny, nazwy planów. Jeśli fakt ma znaczenie, powinien być w tekście strony, a nie domalowany przez JavaScript po załadowaniu. Tę poprawkę przechwyt potwierdza najbardziej bezpośrednio.
- Trzymaj jedną mocną stronę na fakt. Deduplikacja po domenie oznacza, że dwadzieścia niemal-duplikatów zapada się do jednego slotu cytowania. Wystarczy jedna klarowna, kanoniczna strona cennika lub produktu.
- Wiedz, które pytania nigdy nie wyszukują. Jeśli twoi kupujący pytają o rzeczy, na które model odpowiada z pamięci, żadna treść ich nie zdobędzie. Kieruj wysiłek na pytania, które uruchamiają pobranie.
Drugiej połowy, werdyktu, nie da się naprawić edycją strony. Składają się na nią recenzje, dyskusje w społecznościach i niezależne porównania. To praca, która stoi za widocznością w AI, i dlatego samodzielnie napisana strona „najlepszych” nie przenosi tej wagi na ciebie.
Możesz sprawdzić swoje własne, bez specjalnego dostępu
Nie musisz być badaczem, żeby część tego zobaczyć. W ChatGPT otwórz narzędzia deweloperskie przeglądarki, przełącz się na zakładkę Network, włącz „preserve log”, uruchom zapytanie i przeszukaj odpowiedzi pod kątem nazwy pola result_source. Zobaczysz, który pipeline pobrał każdy wynik w twoich własnych sesjach, i nic nie opuszcza twojego komputera. Suganthan dokumentuje pełną metodę, a Olivier de Segonzac opublikował darmowe rozszerzenie do Chrome, które przechwytuje te same dane o rozwinięciu zapytań i pipeline’ach oraz eksportuje je do arkusza. Nie uruchamialiśmy tego przechwytu na cyberlab.team, więc wszystkie liczby powyżej są jego, a nie nasze.
Co potwierdza ta migawka
To jedno konto, kilka dni, zestaw zapytań przechylony w stronę technologii i system, który OpenAI stale zmienia. Procenty będą się zmieniać, jak mówi sam Suganthan, więc opieraj się na strukturze: ChatGPT przypisuje pytanie do kubełka, pobiera przez pipeline’y, nad którymi nie masz kontroli, czyta twoją stronę w poszukiwaniu faktów tylko jeśli potrafi je sparsować, a werdykt bierze z cudzych stron. Migawka nie potwierdza żadnych twierdzeń o tym, ile cytowań przyniesie dana poprawka, i nic nie mówi o funkcjach AI w Google.
Źródła
- Suganthan Mohanadasan, „How ChatGPT Actually Picks Sources (I Read the Network Traffic, Not the Outputs)“, 24 czerwca 2026: suganthan.com
- Ahrefs, „Why ChatGPT Cites One Page Over Another (Study of 1.4M Prompts)“: ahrefs.com
- Olivier de Segonzac, darmowe rozszerzenie do Chrome przechwytujące rozwinięcie zapytań ChatGPT (opis): think.resoneo.com