Советы о том, как попасть в цитаты ChatGPT, обычно рождаются из чтения его ответов и догадок о механике за ними: пишите качественный контент, публикуйте подборки, будьте активны на Reddit. Suganthan Mohanadasan пошёл другим путём. Он открыл сетевую панель браузера и прочитал трафик, который ChatGPT отправляет сам себе. Получилась более механическая картина того, как модель решает, какие страницы загрузить, какие процитировать, а какие проигнорировать. Эта статья пересказывает его захват, добавляет единственные внешние данные, которые его подтверждают, и говорит, что из этого следует, а что нет.
Обновление, июль 2026: поле с пайплайнами, описанное ниже, позже показало пятое значение, bing, на части аккаунтов. Это дополнение разобрано отдельно в материале ChatGPT и источник результатов Bing.
Сначала, пара слов о методе и его границах
Это прочтение одним человеком примерно 1240 записей об источниках, собранных за несколько дней на одном Pro-аккаунте, с запросами, смещёнными в сторону SaaS и техники. Suganthan делит свои находки на два уровня уверенности, и мы сохраняем это деление.
Структурные факты, с высокой уверенностью: они снимаются прямо с провода, одинаково каждый раз. Внутренние имена полей, метки пайплайнов, тот факт, что некоторые вопросы вообще не запускают веб-поиск. Частоты же, только ориентировочные: проценты и рейтинги получены из маленькой, перекошенной в сторону техники выборки, а запросы про здоровье или моду выглядели бы иначе. Механизмы и есть вывод, а точные числа лишь моментальный снимок.
Не всякий вопрос вообще касается веба
Прежде чем ChatGPT что-либо ищет, он раскладывает ваш вопрос по корзинам. Suganthan увидел шесть таких меток намерения, включая одну, которая решает множество споров о видимости в AI: корзина «text» отвечает из тренировочной памяти модели и вообще не ищет в вебе.
Из этого следует прямой вывод. Некоторые вопросы вы попросту не выиграете контентом, потому что для ответа на них ни одна страница не загружается. В его тесте на три из десяти намеренно актуальных, высокоставочных вопросов ответ дали без веб-поиска. И корзину определяет то, как вы формулируете вопрос, а не тема. «Лучший кофе рядом со мной» запускает локальный пайплайн. «Лучшие 4K-телевизоры для покупки» запускают шопинг. «Лучшие 4K-телевизоры с обзорами» остаются в обычном поиске. Тот же предмет, три разные машины, три разных набора победителей.
Поэтому прежде чем волноваться о ранжировании в ответе AI, разберитесь, доходят ли вообще интересующие вас вопросы до веба. Некоторые не дойдут никогда.
Кого загрузить, решают четыре пайплайна
Для вопросов, которые всё-таки идут в поиск, каждый веб-результат несёт внутреннюю метку, указывающую, какой пайплайн его загрузил. Suganthan нашёл четыре значения, и другие специалисты в отрасли независимо обнаружили то же поле. Если по-простому:
- serp, базовый уровень открытого веба, в основном новости.
- labrador похож на лицензированный уровень для солидных издателей (представьте Reuters, the Guardian, the WSJ, Wikipedia, arXiv), которые подтягиваются почти полными выдержками статей, а не короткими сниппетами.
- bright и oxylabs это названия коммерческих скрейпинговых фирм, Bright Data и Oxylabs, и они делают основную тяжёлую работу по открытому вебу. В его выборке Bright Data доминировала в шопинге, финансах и погоде, а Oxylabs тяготела к региональной и местной прессе.
Один запрос про погоду, например, разбросал свои источники по разным пайплайнам: национальные прогнозисты пришли через один скрейпер, региональные газеты, через другой. Вы не управляете тем, какой пайплайн вас подхватит, но эта закономерность, напоминание, что ChatGPT собирает ответ сразу из нескольких систем загрузки, а не ищет по одному индексу, как Google.
Загружено, процитировано и упомянуто это три разные вещи
Большинство советов по видимости размывает это различие. То, что модель прочитала вашу страницу, то, что она сослалась на неё под конкретной фразой, и то, что название вашего бренда просто всплыло в ответе, это три отдельных исхода, и только один из них даёт кликабельную сноску. У каждого своё условие победы:
- Загружено означает, что модель втянула вашу страницу в свой рабочий контекст. Вы этого не видите, и само по себе это ничего вам не даёт.
- Процитировано означает, что ваша страница указана как источник конкретной фразы, кликабельная сноска.
- Упомянуто означает, что название вашего бренда появляется в ответе, часто в виде чипа, но не как источник какого-либо утверждения.
Разрыв между «загружено» и «процитировано» это то место, где теряется много усилий. В выборке Suganthan Reddit загружался 278 раз и цитировался 11 раз. YouTube загружался 201 раз и был процитирован ноль раз. Механическая причина проста: цитаты привязываются к тексту, который модель реально прочитала, а страница YouTube отдаёт метаданные, а не расшифровку, тогда как тред на Reddit это сплошной читаемый текст. И это не случайность маленькой выборки. Ahrefs, изучив 1,4 миллиона промптов, обнаружил, что Reddit цитируется лишь примерно в 1,93% случаев, когда он появляется, и что около двух третей всех загруженных, но не процитированных URL это Reddit. Платформу постоянно используют, чтобы понять тему, и почти никогда не указывают за это.
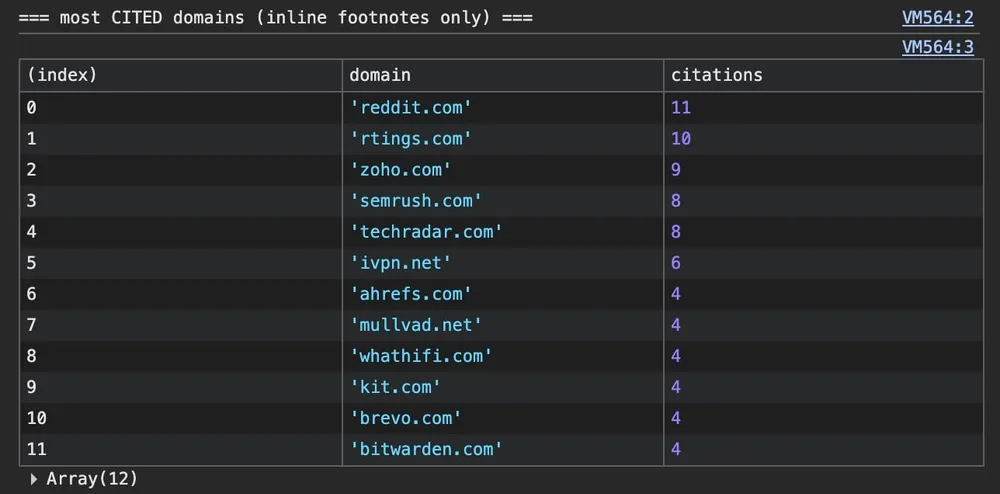
В этом списке прячется ещё одна механика: результаты дедуплицируются по домену. Двадцать жиденьких страниц с одного сайта схлопываются в один слот цитаты. Публикация ещё большего числа однотипных страниц не покупает вам больше присутствия.
Такой же разрыв между «процитировано» и «рекомендовано» виден и в AI Overviews от Google. Это измерение разобрано в материале Почему «мы лучшие» бьёт по вам в AI-поиске.
Один вопрос превращается в десятки поисков
Когда ChatGPT использует режим «мышления» на вопросе-сравнении, он не запускает ваш запрос. Он запускает много запросов. Suganthan наблюдал, как отдельные задачи-сравнения разворачиваются в пятнадцать-сорок подзапросов, и, поскольку эти подзапросы логируются, вы можете прочитать ровно то, о чём спросила модель.
Поведение поразительно буквальное. Он выстреливает site:-зондами прямо по страницам с ценами вендоров. Он угадывает цену, а затем ищет, чтобы подтвердить догадку. Он уходит от сценария и подтягивает конкурентов, которых вы никогда не упоминали, а потом охотится и за их ценами. Когда он читает страницу, он ищет знаки доллара и конкретные слова вроде «Agency» или название тарифа.
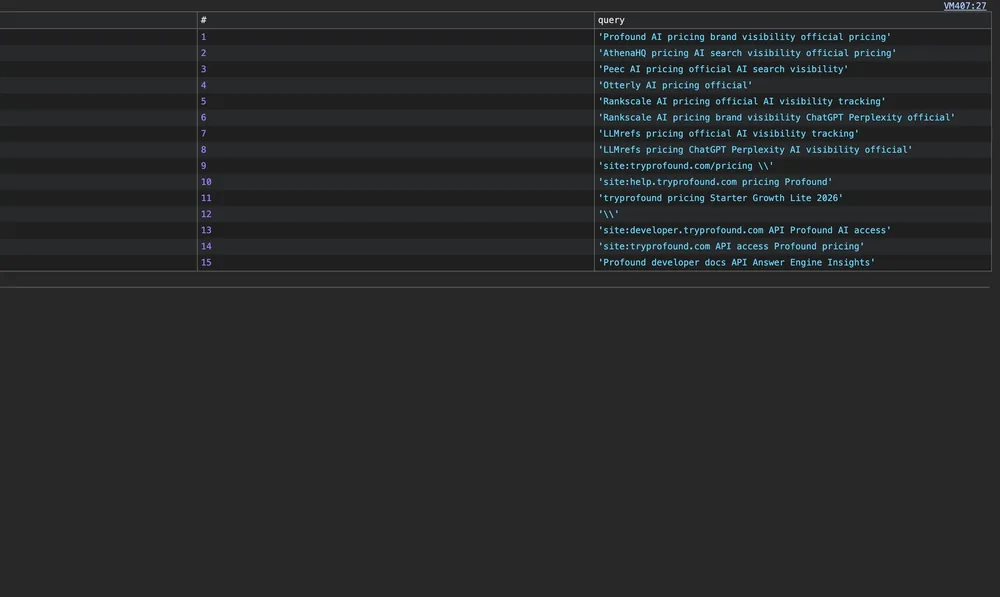
Урок для видимости неудобен: вы конкурируете не за тот вопрос, который набрал пользователь. Вы конкурируете за рой переписанных подзапросов, которых вы никогда не видите, многие из них нацелены на страницы, которые вы, возможно, не оптимизировали, вроде вашей же страницы с ценами.
Факты он читает с вашей страницы, мнение: со всех остальных
Когда Suganthan заглянул в сохранённые рассуждения «мыслящей» модели, стратегия была прописана открытым текстом. Для твёрдых фактов вроде цен и характеристик она предпочитает официальный источник и прямо говорит об этом, выбирая актуальную страницу с ценами вместо более старого упоминания от третьей стороны. Для оценочных суждений вроде «какой инструмент лучше» она относит вердикт к третьим сторонам: обзорным хабам, сравнительным сайтам, сообществам.
Единственная фраза, которую стоит взять из всего захвата, принадлежит ему самому: ChatGPT «читает вашу собственную страницу ради фактов, если может их разобрать, и все остальные, ради мнения». Две разные задачи, два разных источника. Факты о себе вы контролируете. Вердикт нет, и его зарабатывают в другом месте. Остальные материалы этой серии об AI-поиске опираются на это разделение и ссылаются сюда, а не пересказывают его.
Стена JavaScript
Эта находка больше всего касается того, как строятся страницы. Когда модель попыталась вытащить цены с инструментов вроде Profound и Peec, у неё не вышло. Она отметила в собственных рассуждениях, что цен не было в результате, потому что страница загружала их через JavaScript. Не сумев разобрать официальную цифру, она откатилась к цитированию третьей стороны, решив взять данные с обзорного сайта, потому что официальную страницу оказалось слишком трудно прочитать.
Для фактов в этом вся суть. Если ваши ключевые числа, цены, характеристики, наличие, отрисовываются через JavaScript уже после загрузки страницы, модель может загрузить вашу страницу, не суметь прочитать факт и отдать цитату тому, кто написал о вас простым текстом. Вы можете быть первоисточником факта о вашем же бизнесе и всё равно проиграть цитату сравнительному сайту, исключительно из-за того, как построена ваша страница.
Что менять на собственном сайте
Из захвата следуют два действия: сделать факты читаемыми и не ждать пользы от объёма.
- Держите факты в простом, отрендеренном на сервере HTML. Цены, характеристики, локации, часы работы, названия тарифов. Если факт важен, он должен быть в тексте страницы, а не дорисован через JavaScript после загрузки. Именно это исправление захват подтверждает самым прямым образом.
- Держите по одной сильной странице на факт. Дедупликация по домену означает, что двадцать почти-дубликатов схлопываются в один слот цитаты. Хватит одной понятной канонической страницы с ценами или продуктом.
- Знайте, какие вопросы вообще не ищут. Если ваши покупатели спрашивают то, на что модель отвечает из памяти, никакой контент их не выиграет. Направьте усилия на вопросы, которые запускают загрузку.
Вторая половина, вердикт, правкой страницы не лечится. Он складывается из обзоров, обсуждений в сообществах и независимых сравнений. Это работа, которая стоит за видимостью в AI, и именно поэтому самописная страница «лучших» не переносит этот вес на вас.
Вы можете проверить свои запросы сами, без особого доступа
Чтобы кое-что из этого увидеть, не нужно быть исследователем. В ChatGPT откройте инструменты разработчика браузера, переключитесь на вкладку Network, включите «preserve log», запустите запрос и поищите в ответах имя поля result_source. Вы увидите, какой пайплайн загрузил каждый результат в ваших собственных сессиях, и ничего не покидает вашу машину. Suganthan документирует весь метод целиком, а Olivier de Segonzac опубликовал бесплатное расширение для Chrome, которое захватывает те же данные о развороте запросов и пайплайнах и экспортирует их в таблицу. Мы не запускали этот захват на cyberlab.team, так что все числа выше его, а не наши.
Что подтверждает этот снимок
Это один аккаунт, несколько дней, набор запросов с перекосом в технику и система, которую OpenAI постоянно меняет. Проценты будут дрейфовать, как говорит и сам Suganthan, так что опирайтесь на структуру: ChatGPT раскладывает вопрос по корзинам, загружает через пайплайны, которыми вы не управляете, читает вашу страницу ради фактов только если может их разобрать, а вердикт берёт с чужих страниц. Снимок не подтверждает никаких утверждений о том, сколько цитат принесёт то или иное исправление, и ничего не говорит об AI-функциях Google.
Источники
- Suganthan Mohanadasan, «How ChatGPT Actually Picks Sources (I Read the Network Traffic, Not the Outputs)», 24 июня 2026: suganthan.com
- Ahrefs, «Why ChatGPT Cites One Page Over Another (Study of 1.4M Prompts)»: ahrefs.com
- Olivier de Segonzac, бесплатное расширение для Chrome по развороту поисковых запросов ChatGPT (описание): think.resoneo.com